AI locale in 8 millisecondi: un modello da 2B gioca a Snake su RTX 5070 Ti
Un Decision Model da 2B eseguito localmente con EuLLM prende decisioni in circa 8 ms su RTX 5070 Ti. Ecco cosa significa e perché non riguarda soltanto Snake.
Siamo abituati a misurare i modelli linguistici contando quanti token riescono a generare al secondo.
Esiste però un altro scenario interessante.
E se al modello non chiedessimo di scrivere?
E se dovesse semplicemente osservare una situazione e decidere cosa fare?
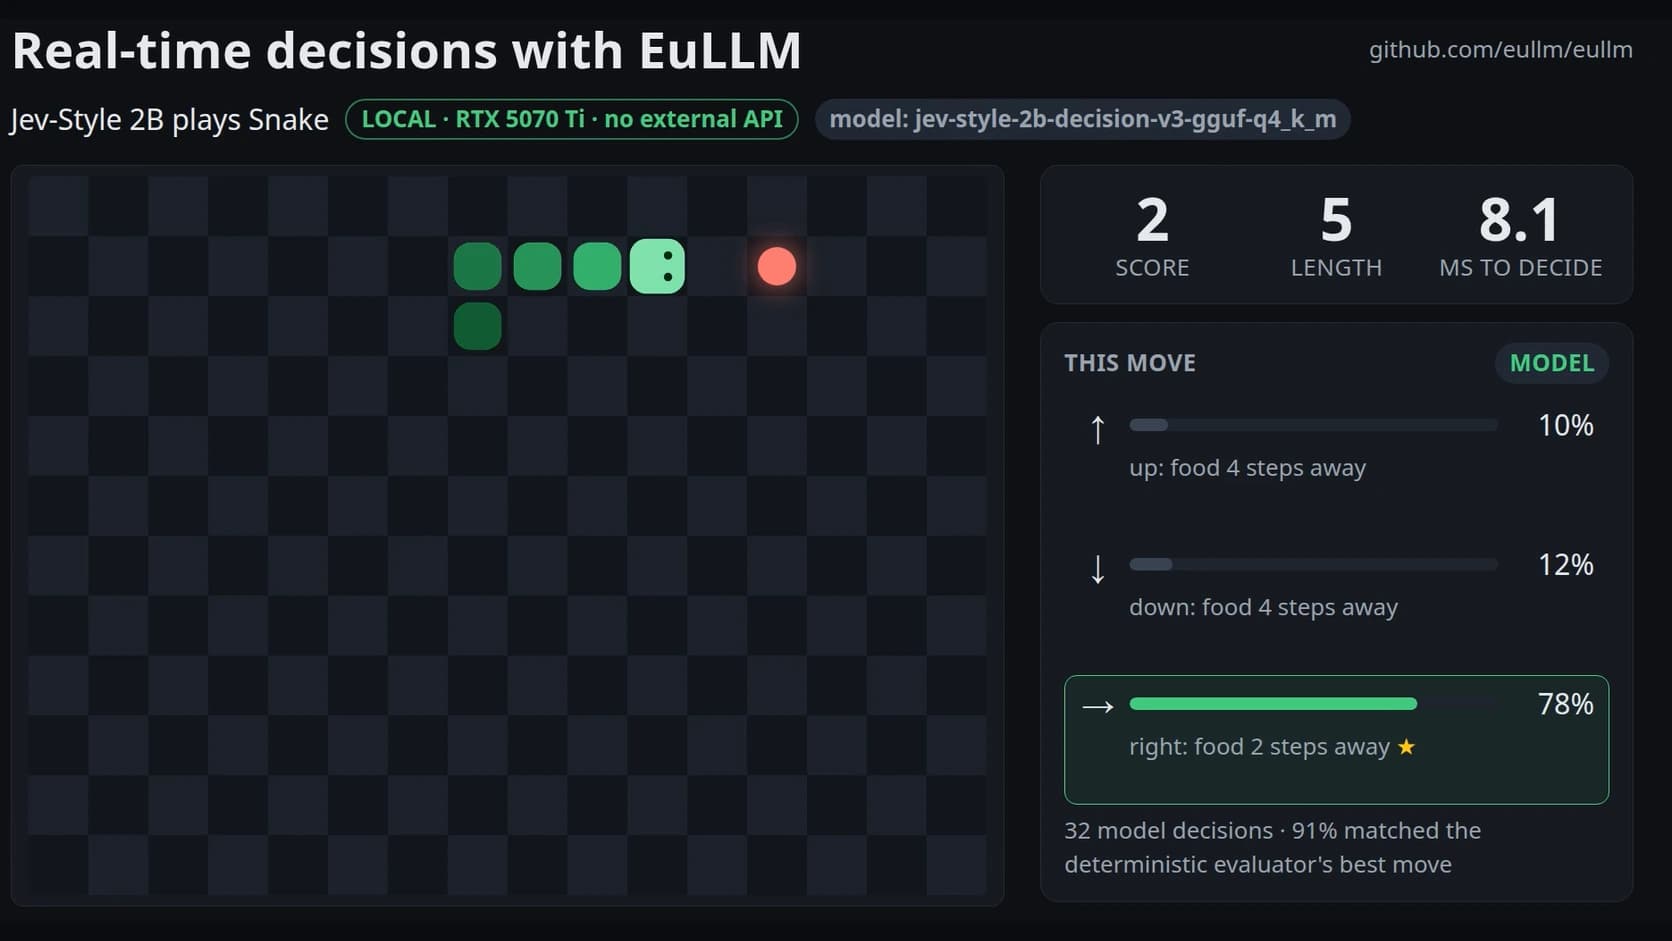
Una demo realizzata con EuLLM mostra un piccolo Jev-style Decision Model da 2 miliardi di parametri che gioca a Snake completamente in locale su una NVIDIA GeForce RTX 5070 Ti.
Il dato che salta immediatamente all'occhio è la latenza: circa 8 millisecondi per prendere una decisione.
Ma il numero diventa interessante soltanto quando capiamo cosa viene misurato.
Un LLM che gioca a Snake
Il funzionamento è abbastanza semplice da osservare.
Ad ogni turno il modello riceve informazioni sullo stato del gioco e deve scegliere la prossima direzione.
Non controlla Snake attraverso un algoritmo tradizionale già programmato per seguire il percorso migliore.
È il modello a valutare la situazione e selezionare l'azione.
Demo: Decision Model 2B gioca a Snake in locale, EuLLM su RTX 5070 Ti
La risposta, però, è minuscola.
Non deve generare cinquanta righe di testo.
Deve essenzialmente scegliere tra poche possibilità.
Questo cambia radicalmente il carico di lavoro rispetto a quello tipico di un chatbot.
8 ms su una GPU consumer
La macchina utilizzata per la demo monta una RTX 5070 Ti con 16 GB di VRAM.
L'inferenza avviene attraverso EuLLM e non utilizza API esterne.
Il modello quantizzato è sufficientemente piccolo da poter essere mantenuto ed eseguito direttamente sulla GPU.
La latenza indicata dalla demo si aggira intorno agli 8 ms per decisione.
Non significa che qualsiasi LLM da 2B risponderà sempre in 8 ms.
Latenza e throughput dipendono dal modello, dalla quantizzazione, dalla dimensione dell'input, dal software utilizzato, dall'hardware e dal tipo di output richiesto.
Il dato ha però valore perché mostra quanto possa essere diversa l'esecuzione di un modello quando il problema non è generare lunghe sequenze di token.
E quel 95%?
La demo mostra anche una seconda metrica: circa il 95% delle decisioni coincide con la migliore azione indicata da un evaluator deterministico.
È importante interpretare correttamente il numero.
Non significa che il modello abbia "il 95% di intelligenza", né che abbia il 95% di accuratezza su qualsiasi problema decisionale.
Esiste un algoritmo separato che conosce le regole del test e calcola quale azione considera migliore.
Le scelte effettuate dal modello vengono confrontate con quel riferimento.
In circa 95 casi su 100 coincidono.
È quindi una metrica legata specificamente alla demo.
Ed è proprio questo confronto a renderla più interessante di un semplice video in cui si vede un'AI giocare.
Perché utilizzare un modello quando esiste già un algoritmo?
Nel caso di Snake, infatti, un buon algoritmo tradizionale è sufficiente e probabilmente rappresenta la soluzione migliore.
La demo non vuole sostituirlo.
Serve a mostrare visivamente un'altra categoria di applicazioni.
Pensiamo a un sistema che riceve un ticket tecnico scritto in linguaggio naturale.
Deve decidere se inviarlo al networking, alla sicurezza, al supporto applicativo o a un operatore umano.
Scrivere a mano tutte le possibili regole diventa rapidamente complicato.
Un piccolo modello specializzato può interpretare il contenuto e restituire semplicemente la destinazione.
Lo stesso principio si applica agli agenti AI.
Un agente può avere cinque strumenti disponibili e deve scegliere quale utilizzare.
Oppure un sistema RAG può recuperare alcuni documenti e deve decidere se le informazioni sono sufficienti per rispondere.
Sono problemi molto diversi da Snake.
La struttura, però, è sorprendentemente simile:
stato → valutazione → decisione → azione.
Perché i piccoli modelli stanno diventando interessanti
Per molto tempo l'evoluzione dei modelli AI è sembrata seguire una sola direzione: più parametri.
Modelli più grandi hanno effettivamente portato miglioramenti impressionanti.
Ma utilizzare il modello più grande disponibile per ogni problema non è necessariamente efficiente.
Quando il dominio è ristretto e le azioni possibili sono limitate, un modello specializzato può essere sufficiente.
E un modello piccolo porta con sé vantaggi molto concreti.
Richiede meno memoria.
Può essere eseguito su hardware relativamente comune.
Riduce il tempo necessario all'inferenza.
E soprattutto può girare localmente.
Nessun viaggio verso il cloud
Nel test EuLLM il dato non parte dalla GPU, attraversa Internet, raggiunge il datacenter di un provider e torna con una risposta.
L'intero processo avviene sulla macchina.
È una differenza che diventa importante soprattutto quando un'applicazione deve eseguire molte decisioni consecutive.
Anche un'API molto veloce deve fare i conti con la latenza della rete.
Dieci o venti chiamate all'interno dello stesso workflow possono trasformare pochi centesimi di secondo in diversi secondi percepibili dall'utente.
L'inferenza locale elimina quella parte del percorso.
Non elimina naturalmente il costo computazionale: l'hardware deve comunque eseguire il modello.
Ma sposta il problema dalla rete alla macchina locale.
Non soltanto GPU da datacenter
Uno degli aspetti più interessanti della demo è proprio l'hardware.
La RTX 5070 Ti non è una GPU professionale dedicata ai datacenter.
È una scheda consumer.
Sedici gigabyte di VRAM pongono comunque limiti importanti alla dimensione dei modelli caricabili interamente sulla GPU, ma modelli da pochi miliardi di parametri quantizzati rientrano perfettamente nella categoria di workload che può diventare interessante su questo tipo di hardware.
È un segnale di come stia cambiando il mercato dell'AI locale.
Il confronto non riguarda più soltanto workstation con GPU da migliaia di euro contro servizi cloud.
Esiste una fascia intermedia composta da piccoli server, workstation e persino alcuni mini-PC con grandi quantità di memoria condivisa.
Decision Model: un termine che sentiremo più spesso?
La definizione non identifica una nuova architettura fondamentale come Transformer o Mixture of Experts.
Descrive piuttosto il ruolo assegnato al modello.
Un Decision Model riceve uno stato o un contesto e produce principalmente una scelta.
La generazione di linguaggio può essere minima o addirittura secondaria.
L'idea sta diventando particolarmente interessante insieme alla crescita degli agenti AI, perché un agente passa gran parte del proprio tempo proprio a decidere cosa fare dopo.
Se quella decisione può essere affidata a un piccolo modello locale invece di interrogare continuamente un modello enorme nel cloud, cambiano costi, latenza e architettura dell'intero sistema.
Snake è soltanto il modo più facile per vederlo
Una demo deve rendere immediatamente comprensibile quello che sta succedendo.
Snake ci riesce molto bene.
Il modello decide male? Lo vediamo.
Decide correttamente? Il serpente continua.
Ma il punto interessante arriva quando sostituiamo le quattro direzioni del gioco con azioni come:
approva, rifiuta, cerca ancora, chiama uno strumento, passa a un operatore.
A quel punto non stiamo più parlando di videogiochi.
Stiamo parlando di come potrebbe essere costruita una parte dei software AI dei prossimi anni.
La demo e il codice di EuLLM sono disponibili sul repository pubblico del progetto: github.com/eullm/eullm.
← Tutti gli articoli